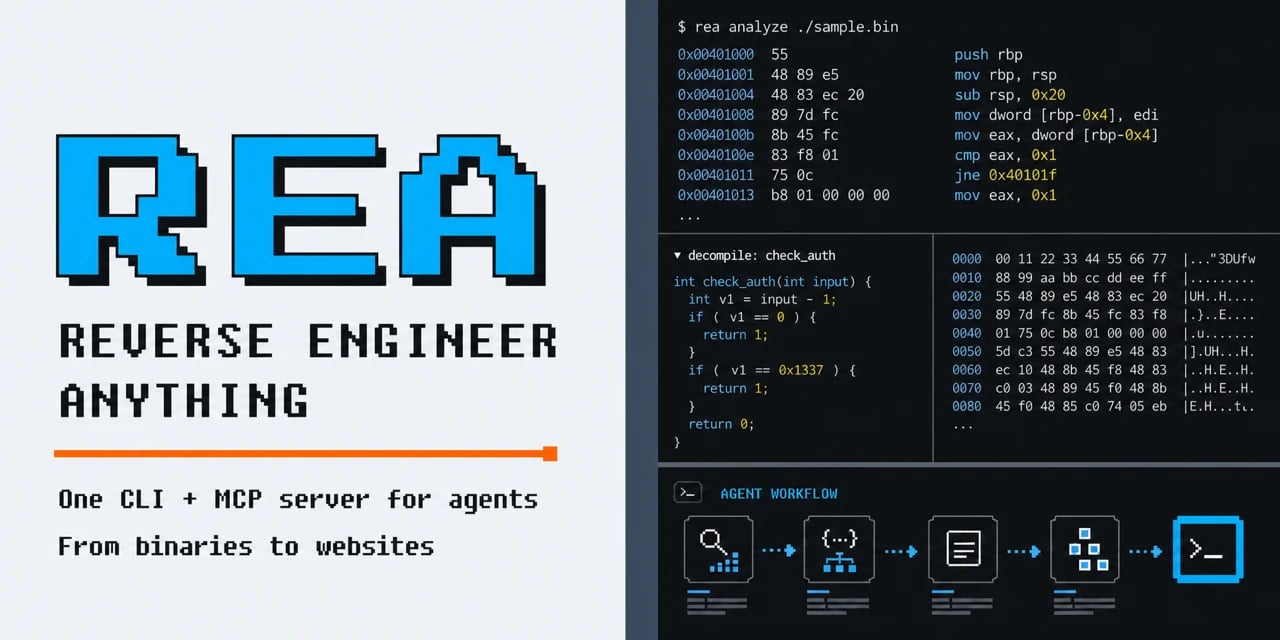
Chiedere a un modello linguistico di clonare una funzionalità complessa da un'applicazione proprietaria senza fornirgli il codice sorgente ha prodotto finora solo allucinazioni plausibili. Con REA (Reverse Engineer Anything), il paradigma cambia: grazie allo standard Model Context Protocol, gli agenti AI ottengono un ponte operativo verso disassemblatori e analizzatori locali per estrarre logica binaria, protocolli IPC e flussi applicativi con prove verificabili.
Che cos'è REA e perché colma un vuoto critico nell'ingegneria inversa assistita da AI
Il reverse engineering (l'analisi strutturale e funzionale di un software compilato in assenza di codice sorgente) è storicamente una disciplina riservata a specialisti capaci di padroneggiare strumenti ostici come Ghidra, Hopper o IDA Pro. Quando uno sviluppatore chiede a un assistente di codifica moderno come Claude Code, Cursor o Grok Build di replicare un comportamento osservato su un'app esistente, il modello tenta tipicamente di indovinare l'implementazione basandosi sul testo dei prompt.
REA (morluto/rea) colma questo divario integrandosi come server conforme al Model Context Protocol (MCP), un'interfaccia standardizzata che consente ai modelli di intelligenza artificiale di interrogare e controllare strumenti esterni nel proprio ambiente operativo locale. Invece di tirare a indovinare, l'agente esegue comandi mirati su REA per ispezionare il binario o l'archivio, estrarre pseudocodice e tabelle di simboli, esaminare le chiamate di sistema e restituire un'analisi supportata da evidenze univoche.

Come opera REA: dall'interrogazione dell'agente alla prova tangibile
Il principio architetturale di REA privilegia l'esecuzione in locale e la tracciabilità delle prove. Ogni risposta inviata all'agente include non solo il codice derivato o lo pseudocodice, ma anche le catene di riferimenti incrociati, i vincoli e le incertezze metodologiche residue.
La sequenza d'indagine segue passaggi rigorosi:
Aggancio del contesto: L'utente formula un'intenzione in linguaggio naturale («Capisci come funziona la ricerca nell'app Notes e crea una funzione equivalente»).
Scansione strutturale: REA determina il formato del file (binario x86/ARM, pacchetto ASAR Electron, assembly .NET, bytecode Android o archivio PCK di Godot).
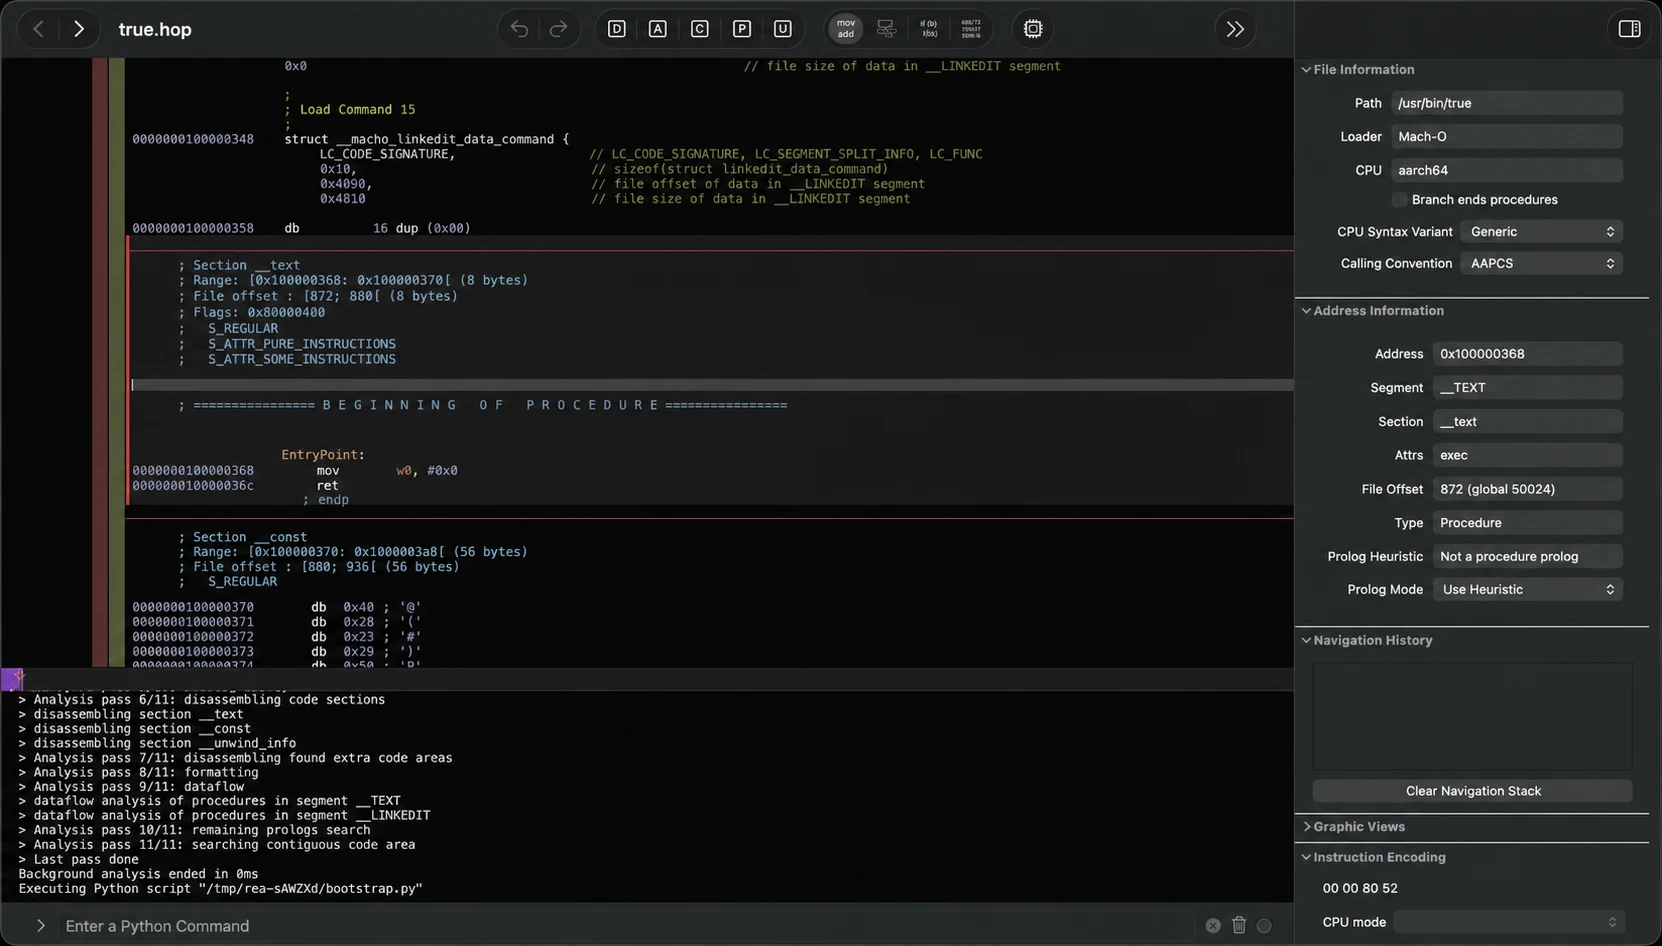
Disassemblaggio e decompilazione: Se il target richiede un'analisi binaria approfondita, REA attiva l'engine prescelto (Hopper, Ghidra, IDA Pro o Rizin) mantenendo il controllo entro timeout prefissati configurabili tramite variabili d'ambiente (come
REA_GHIDRA_STARTUP_TIMEOUT_MS).Estrazione delle evidenze: Vengono estratti i selettori di dispatch, le tabelle di stringhe, i registri macchina o le chiamate IPC (Inter-Process Communication).
Sintesi autonoma: Con il report in mano, l'agente converte la logica isolata in codice moderno (es. C, C++ o TypeScript) ed elabora i casi di test per verificarne la parità funzionale.
Lo spettro di analisi: dai binari compilati ai modelli generativi
A differenza dei decompilatori monolitici, REA è stato progettato per catalogare ambienti software compositi, inclusi gli stack moderni basati su framework web e artefatti di machine learning.
Categoria Target | Dati e prove estratti da REA | Prerequisiti analitici |
|---|---|---|
Binari nativi | Pseudocodice, istruzioni assembly, tabelle simboli, riferimenti incrociati e mitigazioni | Hopper, Ghidra o IDA Pro installati localmente |
App JavaScript & Electron | Albero dei moduli, rotte di navigazione, canali IPC, source maps e binding nativi | Node.js (≥22.19, ≥24.11 o 26+) e procps |
Assembly gestiti .NET | Metadati CIL, istruzioni Intermediate Language, chiamate native P/Invoke | Nessuno (motore statico integrato) |
Pacchetti Android (APK) | Manifest decodificato, classi smali, metodi Java/Kotlin decompilati | Headless JADX e JDK configurati |
Artefatti di modelli AI | Metadati GGUF / safetensors, layout dei tensori e hash crittografici | Nessuno (ispezione header integrata) |
Bytecode EVM & WASM | Selettori di funzione, offset, mutabilità dello storage, disassembly WAT | WABT 1.0.42 (per WASM), interprete EVM x64 locale |
Guida pratica: installazione e configurazione passo-passo
Configurare REA con il proprio agente AI
- 1Verifica dei requisiti di sistemaAssicurati di disporre di Node.js (versione 22.x >=22.19, 24.x >=24.11 o 26+) e di npm funzionanti sul terminale.
- 2Avvio dell'installazione automatizzataEsegui nel terminale il comando 'npx rea-agents setup'. Lo script rileva gli agenti installati (Claude Code, Cursor, Codex, Gemini CLI o Grok Build) e prepara i file di configurazione.
- 3Scelta e autorizzazione dei providerApprova l'inserimento delle istruzioni di workflow e la configurazione del server MCP. Se richiesto, autorizza l'eventuale download e setup del motore Hopper per l'ispezione dei binari nativi.
- 4Riavvio e test operativoRiavvia il client del tuo agente AI. Da questo momento puoi interrogare l'agente chiedendogli direttamente di analizzare file eseguibili, archivi ASAR o pacchetti APK presenti sul tuo disco locale.
Per ispezioni rapide da riga di comando senza passare da un'interfaccia di chat, REA mette a disposizione comandi dedicati:
shellnpx -y rea-agents@latest analyze-javascript-application /percorso/assoluto/app --json
Per le installazioni globali, il pacchetto include un meccanismo di aggiornamento rapido che protegge il buffer del terminale troncando output superiori a 4 MiB:
shellnpm install --global rea-agents rea update
Casi studio reali: dove REA ha dimostrato il proprio valore
L'efficacia di uno strumento di reverse engineering assistito da AI si misura sulla precisione con cui ricrea comportamenti esatti senza alterare la logica originale. Tre dimostrazioni pratiche pubblicate dal progetto evidenziano questa flessibilità:
1. DX-Ball e l'algoritmo di panning audio
Nel videogioco classico DX-Ball, il calcolo della spazializzazione stereofonica dipende dalla posizione della pallina rispetto alla barra di gioco. Guidato da REA, l'agente ha tracciato la funzione specifica x86 all'interno del disassemblatore, convertito il flusso di istruzioni assembly in puro codice ANSI C e convalidato la routine su 3.205 test case, riproducendo perfettamente tutti i 63 byte compilati della funzione originale.
2. Notion e il ponte appunti su Electron
Tracciare come un'app complessa gestisce la formattazione avanzata della clipboard richiede di saltare attraverso più confini architetturali. REA ha consentito di mappare le API del renderer di Notion, attraversare il file di preload e seguire i messaggi IPC fino al processo main, rivelando l'esatta struttura dei dati scambiati tra sandbox e sistema operativo host.
3. TH04: decodifica trigonometrica a 16-bit
Nel contesto della preservazione del software per piattaforma retro PC-98, REA ha esaminato le istruzioni DOS a 16-bit del titolo Touhou 04 per estrarre la routine di calcolo degli angoli di tiro dei proiettili, consentendo di generare codice C++ verificato contro i comportamenti del compilatore dell'epoca.
- ✓Architettura unificata tramite Model Context Protocol (MCP) compatibile con i principali agenti sul mercato
- ✓Analisi statica e dinamica eseguita al 100% in locale senza esporre file proprietari su server terzi
- ✓Supporto esteso: dai vecchi binari a 16 bit ai formati moderni di modelli neurali (GGUF, safetensors)
- ✓Tracciabilità scientifica: il tool riporta le evidenze grezze (offset, opcode) riducendo le allucinazioni dell'AI
- ✗L'analisi binaria avanzata richiede licenze o installazioni esterne (Ghidra, Hopper, IDA Pro)
- ✗Configurazione iniziale non banale su ambienti Linux, dove servono utility specifiche come procps, pwntools o TShark
Un acceleratore formidabile per l'ingegneria inversa etica
REA colma con eleganza il divario tra strumenti di decompilazione professionale e intelligenza artificiale contestuale. Pur richiedendo una conoscenza di base dell'architettura software per formulare i prompt corretti e gestire dipendenze esterne come Ghidra o JDK, rappresenta a oggi la soluzione più avanzata e aperta per consentire agli agenti AI di 'leggere' la realtà binaria senza inventarla.